Где смотреть ключевые метрики
CPU / RAM — requests и фактическая утилизация
Дашборд: Kubernetes / Pods.
-
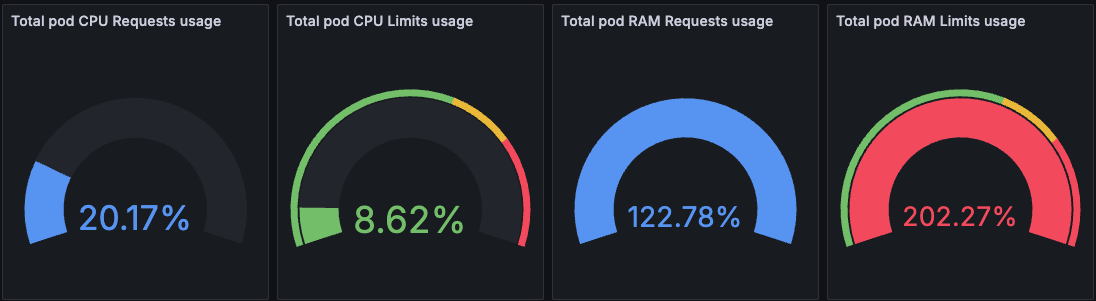
Total pod CPU Requests usage -
Что показывает: фактическое потребление CPU относительно заявленных pod-level requests.
-
Как считается:
sum(rate(container_cpu_usage_seconds_total{...}[window])) / sum(kube_pod_container_resource_requests{...}). -
Как интерпретировать: значение 21 %, например, означает, что pod использует ~21 % от запрошенного CPU. >100% значит, что нагрузка превышает requests и начинается конкуренция за ресурсы.
-
Total pod CPU Limits usage -
Метрика: то же, но деление на
kube_pod_container_resource_limits. >100% означает, что контейнер выходит за лимиты. Так как не во всех подах выставлены лимиты, показатель может быть нерепрезентативным. -
Total pod RAM Requests usage/Total pod RAM Limits usage -
Метрики:
sum(container_memory_working_set_bytes{...}) / sum(kube_pod_container_resource_requests{...})и аналогично для limits. -
Интерпретация: 50% = используем половину заявленной памяти; 95%+ означает, что скоро возможны OOM или eviction.
-
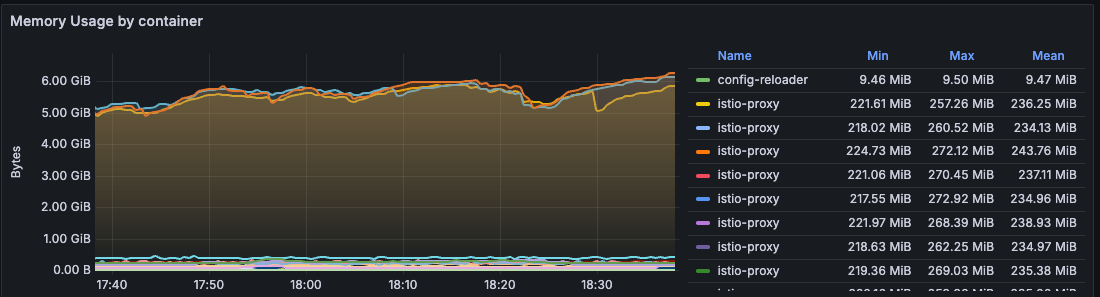
CPU Usage by container,Memory Usage by container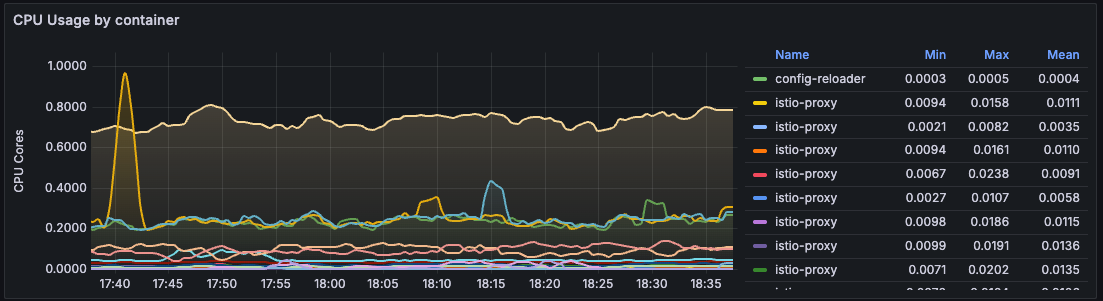
-
Метрики:
sum(rate(container_cpu_usage_seconds_total{...}))иsum(container_memory_working_set_bytes{...})по контейнерам. -
Интерпретация: абсолютное потребление CPU (в ядрах) и RAM. Удобно смотреть, какой контейнер потребляет больше всего.
-
CPU Usage / Requests & Limits by container,Memory Usage / Requests & Limits by container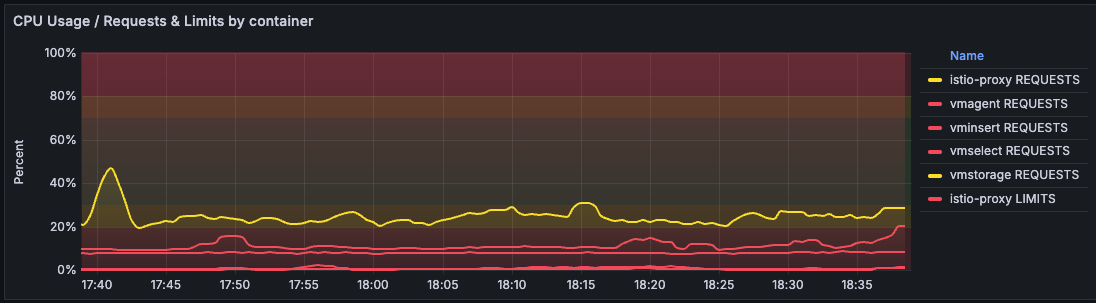
-
Метрики: отношение usage контейнера к его requests/limits.
-
Интерпретация: >100% по requests → контейнеру мало ресурсов; >100% по limits — фактическое превышение лимита (у CPU throttling, у RAM OOM).
RPS или входной трафик
-
HTTP RPS:
Kubernetes / Istio Service Mesh→Request Rate by Service & Response Code.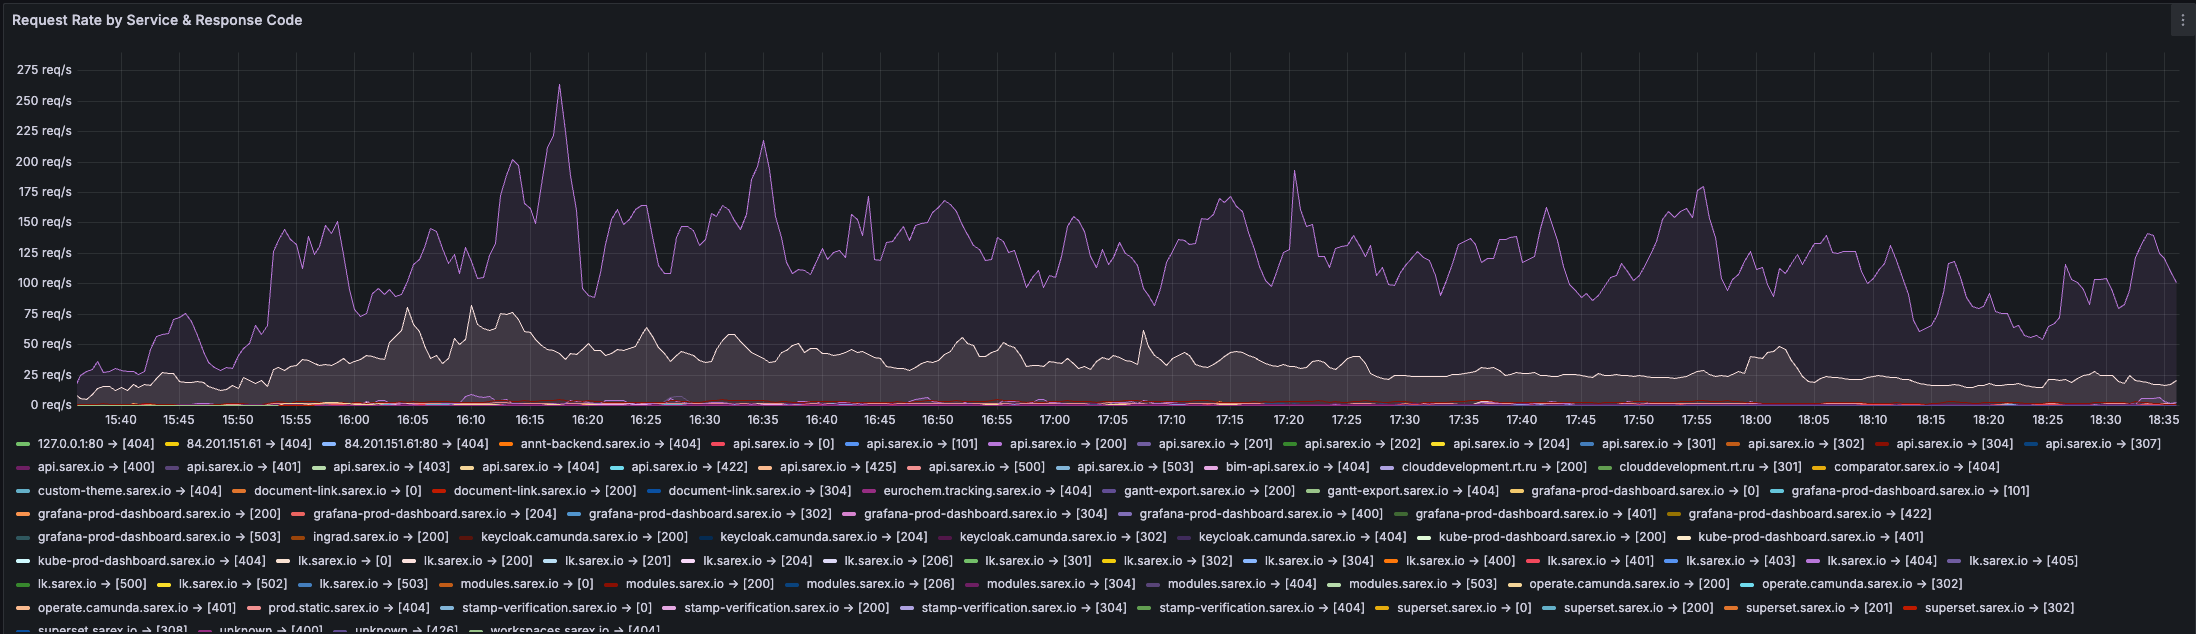
-
Метрика:
sum(rate(istio_requests_total[$__rate_interval])) by (request_host, response_code). -
Интерпретация: показывает, сколько запросов проходит через истио-инфраструктуру по каждому host и статусу. Рост 5xx — сигнал на деградацию сервиса.
-
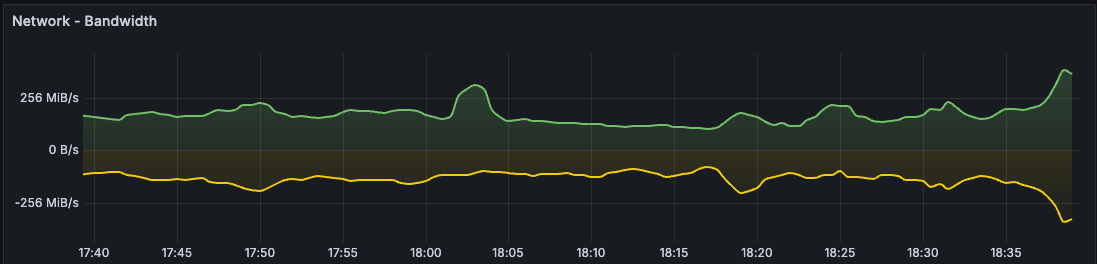
Входной трафик (MB/сек или пакеты):
Kubernetes / Pods→Network - Bandwidth,Network - Packets Rate.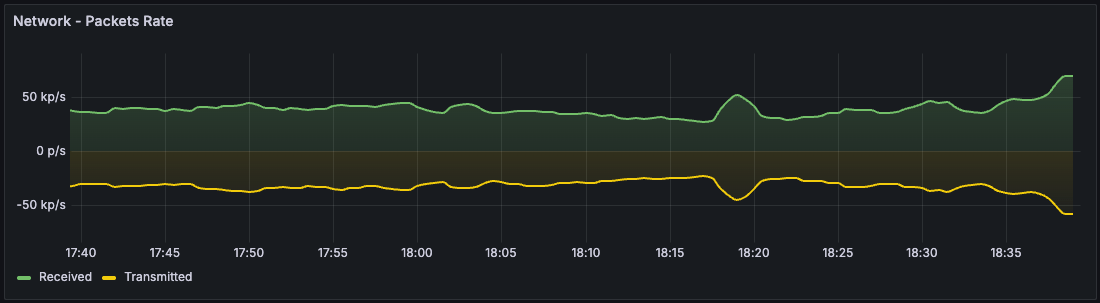
-
Метрики:
sum(rate(container_network_receive_bytes_total{...}))и аналогичная для transmit. -
Интерпретация: сколько байт/пакетов в секунду под принимает или отправляет. Удобно, если сервис не под Istio.
OOMKilled и рестарты
-
Дашборд:
Kubernetes / Pods. -
Container Restarts by container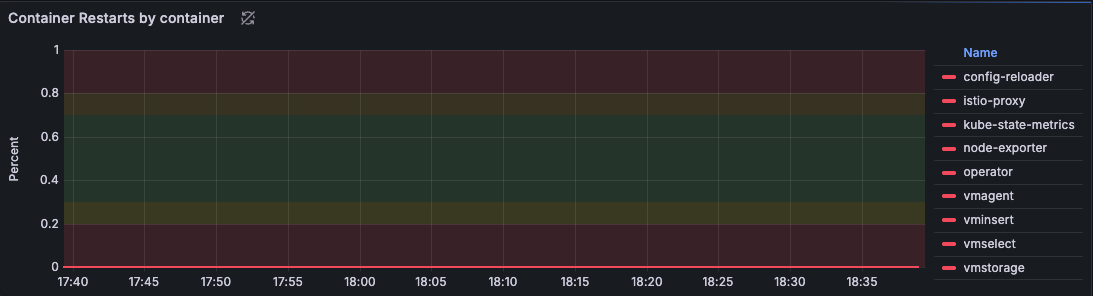
-
Метрика:
sum(increase(kube_pod_container_status_restarts_total{...}[window])). -
Интерпретация: рост показателя означает нестабильность контейнера; >3-5 рестартов в короткий период — повод разбираться.
-
OOM Events by container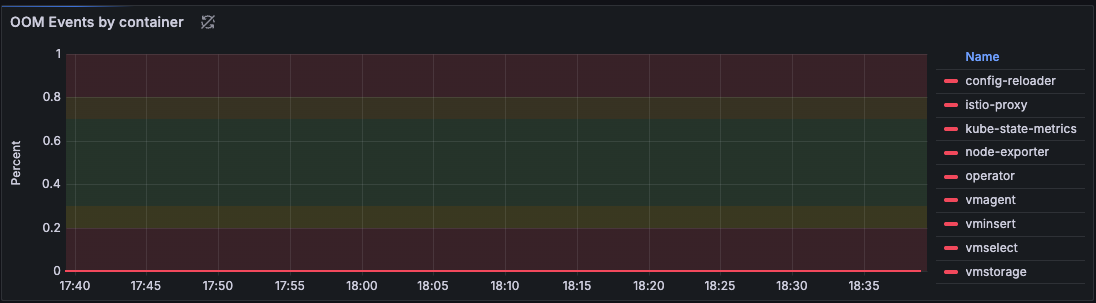
-
Метрика:
sum(increase(container_oom_events_total{...}[window])). -
Интерпретация: любая точка >0 показывает, что контейнер убили из-за нехватки памяти. Нужно поднять лимиты или оптимизировать потребление.
-
Сводка:
Kubernetes / Cluster Health→Top Restarts,OOMKilled Containers— списки проблемных pod'ов.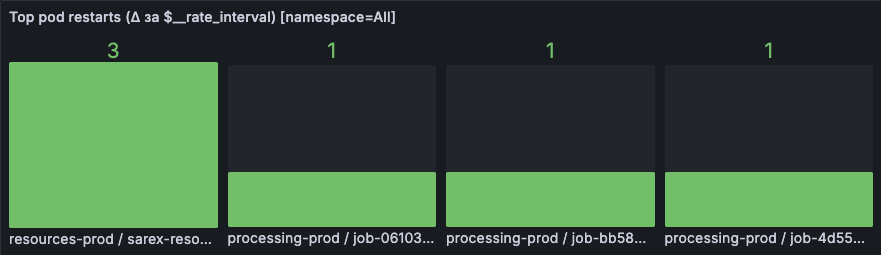
Количество живых/мёртвых подов
- Дашборд:
Kubernetes / Cluster Health.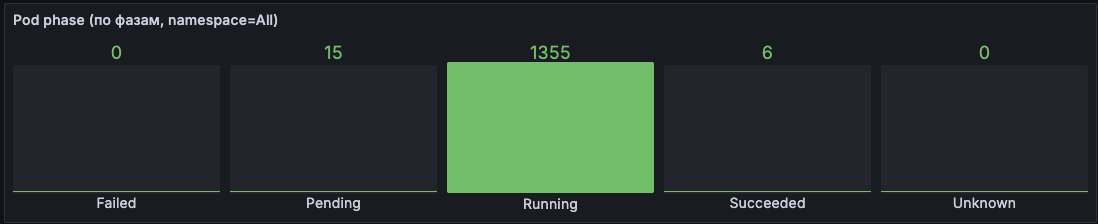
Pods by Phase(метрикаkube_pod_status_phase) — распределение по фазамRunning,Pending,Failed.
HTTP status codes
-
Дашборд:
Kubernetes / Istio Service Mesh. -
Request Rate by Service & Response Code— количество запросов каждого статуса. -
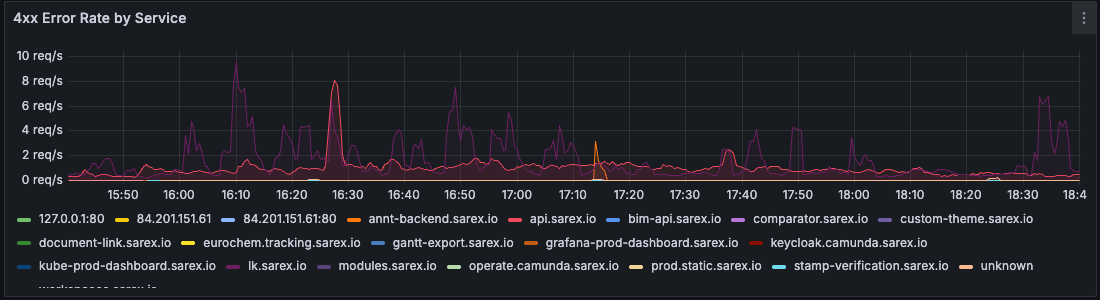
4xx Error Rate by Service,5xx Error Rate by Service— выделенные панели по ошибкам.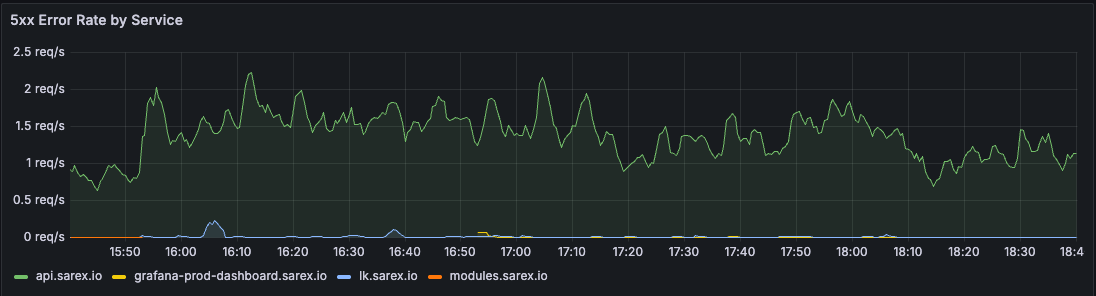
-
Интерпретация: рост 4xx → проблемы на уровне клиента/валидации; рост 5xx → деградация сервиса/зависимость.