GoAlert — Гайд по использованию
Что такое GoAlert
1. Прием и агрегация алертов - Получает уведомления от систем мониторинга (в нашем случае — VictoriaMetrics) - Дедуплицирует повторяющиеся алерты - Группирует связанные инциденты - Поддерживает различные уровни критичности (severity)
2. Escalation Policies (Политики эскалации) - Определяют, кто и в какой последовательности должен быть уведомлен об инциденте - Настраиваются по уровням: первая линия → вторая линия → менеджмент - Автоматически передают инцидент следующему уровню, если проблема не решена в заданное время - Пример: DevOPS (15 мин) → CTO (30 мин)
3. On-Call Schedules (Расписания дежурств) - Ротация дежурных по часам, дням, неделям - Поддержка multiple schedules (рабочее время, нерабочее время, праздники) - Автоматическая замена дежурных по расписанию - Возможность переназначить дежурство (overrides) - Интеграция с календарями (Google Calendar, iCal)
4. Уведомления (Notifications) - Множественные каналы: SMS, Phone calls, Email, Push notifications - Интеграции с мессенджерами: Slack, Telegram, Microsoft Teams - Настраиваемые правила уведомлений для каждого пользователя - Подтверждение получения алерта (acknowledgement)
5. Services (Сервисы) - Логическая группировка алертов по компонентам инфраструктуры - Каждый сервис имеет свою эскалацию и расписание дежурств - Maintenance Windows — плановые окна обслуживания без алертов - История инцидентов и статистика по сервису
6. Управление инцидентами - Ручное создание инцидентов - Назначение ответственных - Комментарии и логирование действий - Закрытие инцидентов с указанием решения - Постмортем и анализ инцидентов
Доступ к GoAlert
GoAlert защищен OIDC-авторизацией. Для входа используйте свои корпоративные учетные данные в Zitadel.
При первом входе система автоматически создаст ваш профиль. Доступ к алертам осуществляется путем добавления пользователя в Escalation Policy для окружения (stage/prod).
Подключенные сервисы
В GoAlert интегрированы два источника алертов:
1. Alertmanager Production
- Получает алерты от VMAlert и VMAlertmanager в production окружении
- Показывает критичные проблемы данном окружении
2. Alertmanager Stage
- Получает алерты от VMAlert и VMAlertmanager в stage окружении
- Позволяет отслеживать проблемы в данном окружении
Каждый сервис отображается как отдельный Service в GoAlert.
Интерфейс
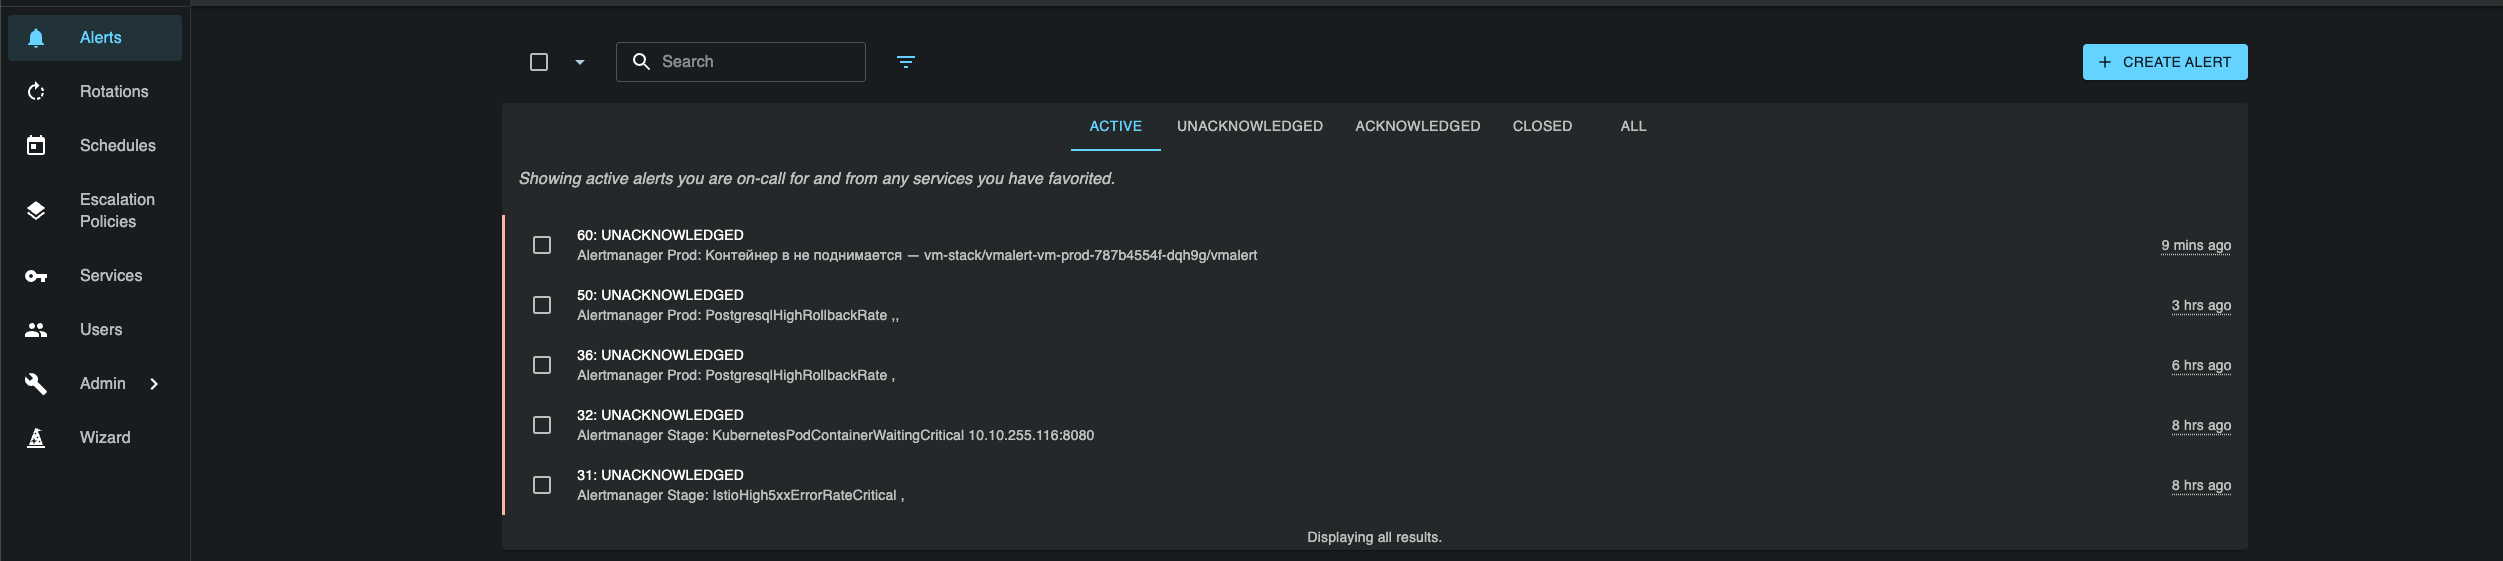
Главная страница (Dashboard)
Главными компонентами на данной странице являются:
- Alerts — текущие активные алерты, требующие внимания
- Services — список подключенных сервисов (Prod, Stage)
Страница алерта
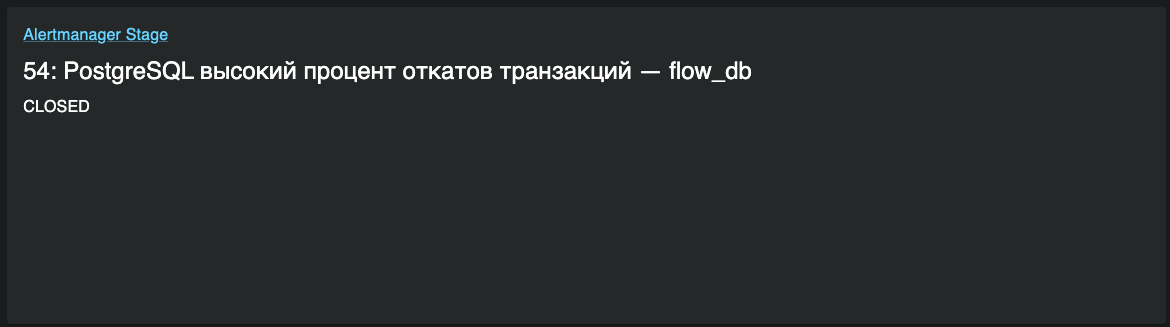
При клике на алерт вы увидите:
-
Название алерта — краткое описание проблемы
-
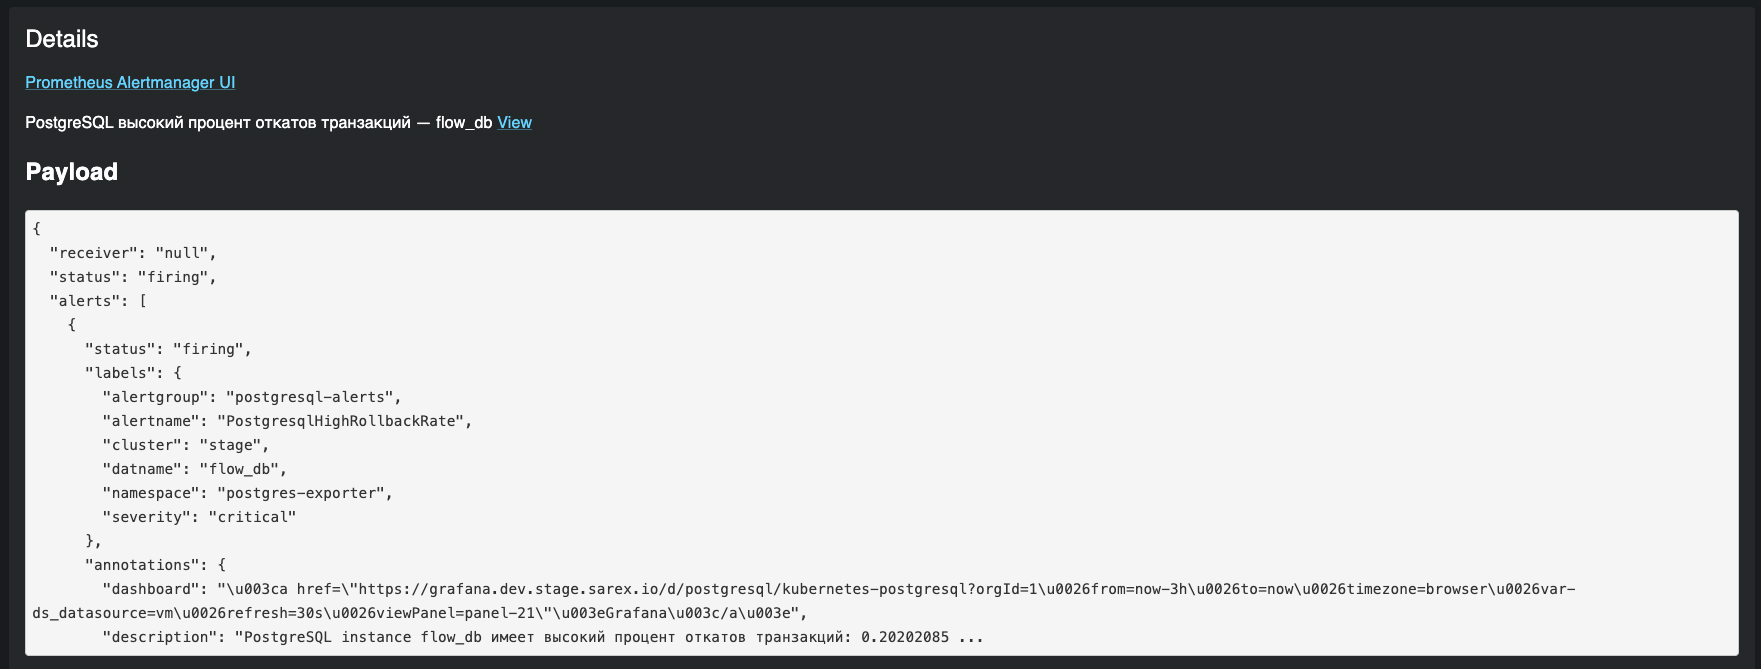
Details — детальное описание алерта, а также ссылки на источник алерта, а в частности на VMAlert и VMAlertmanager. Там можно посмотреть более детальную информацию, включая информацию о самом алерте, а также запросе, который используется для его формирования. Сервисы закрыты доменной авторизацией Zitadel. Также там можно посмотреть полный payload алерта.
- Ссылка на VMAlert — посмотреть правило алерта и его историю
- Ссылка на VMAlertmanager — посмотреть статус алерта в Alertmanager
- Ссылка на Grafana Dashboard в payload алерта — открыть дашборд с графиками проблемного компонента
Пример работы с алертом
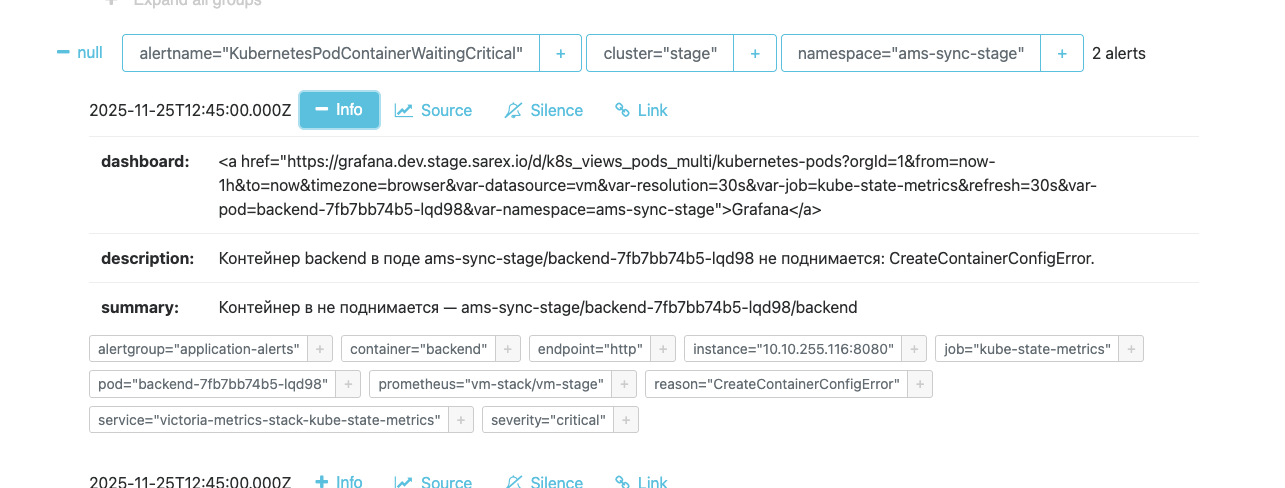
Сценарий: Пришел алерт KubernetesPodContainerWaitingCritical
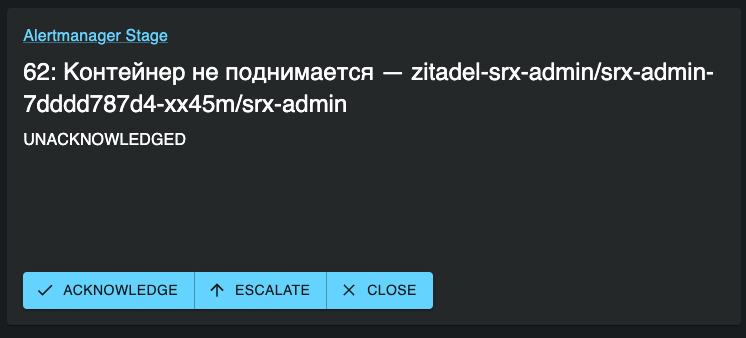
- Откройте алерт в GoAlert
-
Прочитайте описание — в каком кластере, namespace и поде произошла проблема. В примере выше мы видим, что алерт пришел из сервиса Alertmanager Stage. Смотрим детали алерта:
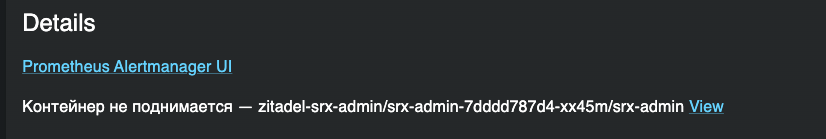
-
Можем посмотреть более подробную информацию алерта по ссылкам, а также его полный payload. В payload можем перейти по ссылке на дешборд в Grafana и увидеть связанные с компонентом графики.
- После устранения проблемы алерт автоматически закроется
Описание алертов
Ниже описаны все типы алертов, которые приходят в GoAlert из системы мониторинга VictoriaMetrics.
Алерты приложений и рабочей нагрузки
Проблемы с утилизацией памяти (OOMKiller):
- KubernetesContainerOomKillerCritical — контейнер завершен из-за нехватки памяти (5+ раз за 15 минут)
Проблемы с доступностью подов:
- KubernetesPodContainerWaitingCritical — контейнер не может запуститься (CrashLoopBackOff, ImagePullBackOff, CreateContainerError)
HTTP ошибки:
- IstioHigh5xxErrorRateCritical — сервис возвращает более 30% ответов с кодом 5xx за последние 5 минут
Проблемы с CPU:
- ContainerHighThrottleRateCritical — контейнер троттлится по CPU более 30% времени (более 1 часа)
- ContainerHighCpuUsageToRequestCritical — контейнер потребляет более 80% от зарезервированного CPU
Проблемы с памятью:
- ContainerHighMemoryUsageToRequestCritical — контейнер использует более 80% от выделенной памяти
Алерты PostgreSQL
Подключения:
- PostgresqlTooManyConnections — использовано более 80% от максимального числа подключений
Deadlocks (взаимные блокировки):
- PostgresqlDeadLocks — обнаружено более 5 deadlocks за минуту
- PostgresqlHighRateDeadlock — высокий уровень deadlocks (более 1 дедлока за минуту)
Транзакции:
- PostgresqlHighRollbackRate — более 20% транзакций откатываются
- PostgresqlLongRunningTransaction — транзакция выполняется более 10 минут
Алерты хранилища (PVC)
Свободное место на дисках:
- PVFreeSpaceBelow5Percent — критично мало места на PVC (< 5%)
- PVFreeSpaceBelow10Percent — мало места (5-10%) на PVC
- PVFreeSpaceBelow15Percent — место на PVC заканчивается (10-15%)
Алерты Camunda Zeebe (workflow engine)
Здоровье партиций:
- ZeebePartitionUnhealthy — партиция Zeebe в нездоровом состоянии
Проблемы обработки:
- ZeebeStreamProcessorStalled — не обрабатываются события более 10 минут
- ZeebeExporterStalled — экспорт событий остановлен более 10 минут
Инциденты:
- ZeebePendingIncidents — есть необработанные инциденты в workflow
Backpressure:
- ZeebeDroppedRequestsHigh — отклоняется более 20 запросов в секунду
- ZeebeDroppedRequestsElevated — отклоняется более 5 запросов в секунду
Задержки:
- ZeebeProcessingLatencyHigh — задержка обработки более 5 секунд (95-й перцентиль)
- ZeebeProcessingLatencyElevated — задержка обработки более 1 секунды (95-й перцентиль)
Текущие ограничения
На данный момент не работают:
-
Эскалации алертов — автоматическая передача алерта следующему уровню, если он не обработан
-
Расписания дежурств (On-Call Schedules) — ротация дежурных по времени/дням
-
Интеграции — уведомления в Loop, почту, SMS, звонки.
Все эти функции запланированы к внедрению и будут доступны в будущем.